 Biógrafo
Diário por voz
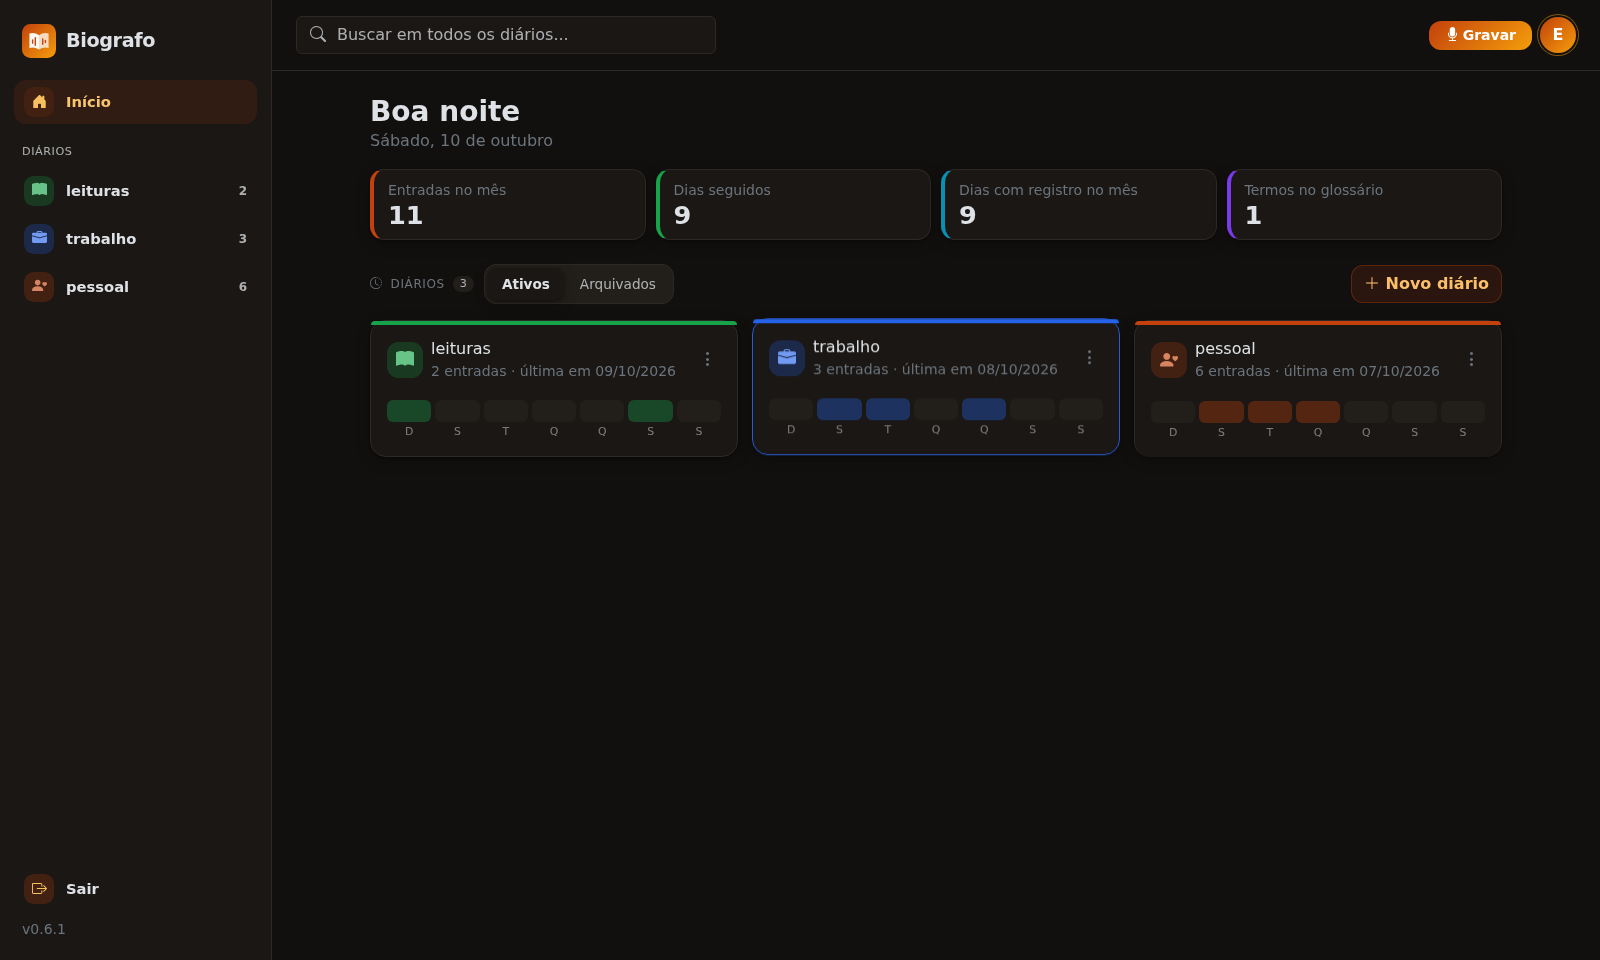
Por anos tentei manter um diário escrito, mas depois de alguns meses eu sempre desistia. Também tentei um diário só em áudio, mas sem poder pesquisar depois ou ler um trecho rápido, ele não ajudava muito. Juntando o útil ao agradável, pensei num app que me fizesse aprender Django e usar LLM num projeto de verdade, e que no fim me desse o diário: eu gravo o áudio, e a transcrição e a organização do texto ficam com a LLM.
Por que Django
Esse projeto também foi uma forma de treinar coisas que eu nunca tinha usado. Minha experiência com Python é toda com Flask e FastAPI, e eu queria trabalhar com Django de verdade. Sempre gostei da ideia de um framework com baterias incluídas: nos mais minimalistas sobra muito espaço para decisões erradas na base do projeto. Flexibilidade é boa quando existe uma visão clara de como moldar essa base ou de como isolar a infraestrutura do domínio. Mas quando sou só eu e quero as coisas feitas de forma rápida, simples e bem feita, ter um caminho já traçado ajuda mais. Sempre tive vontade de testar Ruby on Rails, e no mundo Python o mais perto disso é o Django.
HTML renderizado no servidor
No front, eu não queria uma aplicação separada. Na minha carreira inteira trabalhei com uma API que serve JSON e uma single page application consumindo. Eu queria experimentar o outro paradigma e ver como uma aplicação se estrutura com o back renderizando HTML, mesmo que ele ainda precise devolver JSON para as partes mais interativas da tela. O HTMX foi a chance de testar essa ideia: ter reatividade sem um projeto JavaScript grande e todos os problemas que vêm junto.
LLM sem framework
Também queria usar LLM num projeto real, sem ferramentas como LangGraph. Chamada à API, transcrição, validação da resposta e gestão do prompt já deram bastante aprendizado.
Um player sob medida
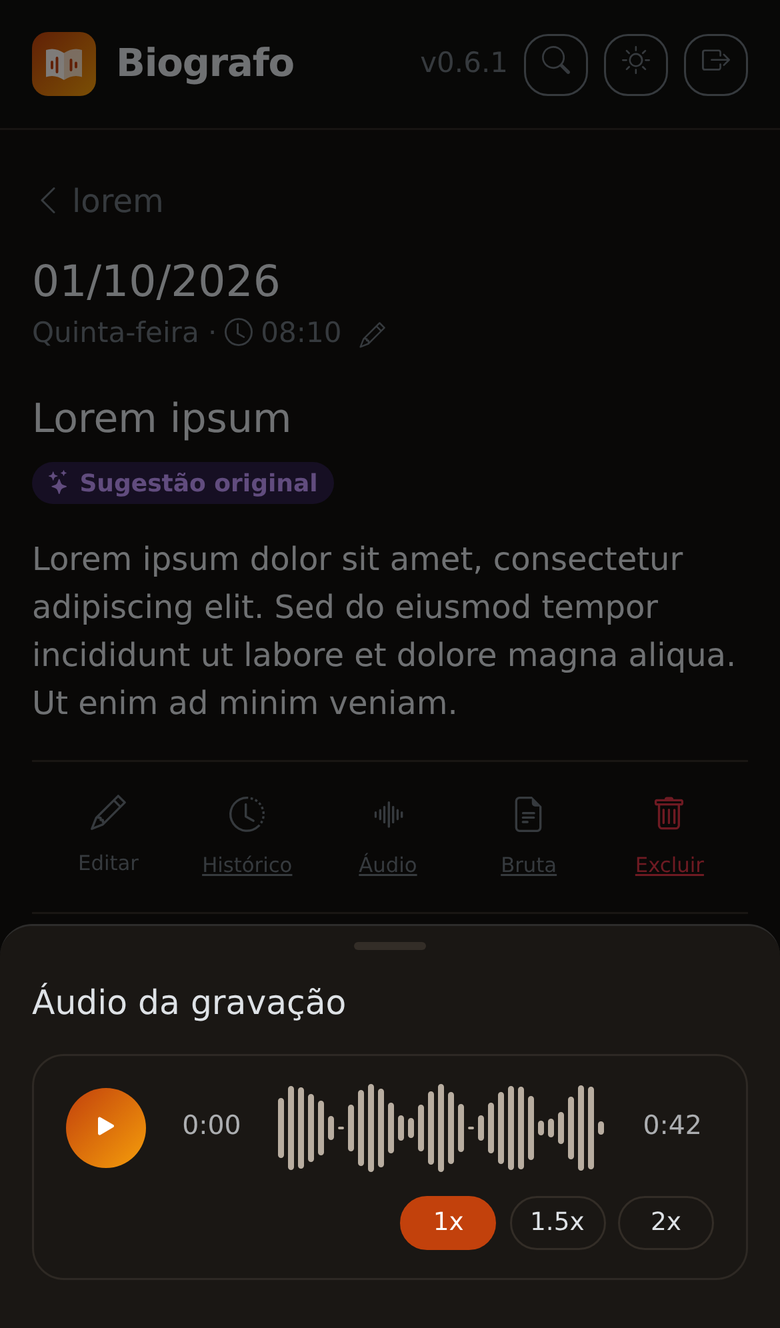
Para tocar os áudios usei o wavesurfer.js, uma biblioteca flexível e poderosa que me deu uma ideia de como montar um player do meu jeito.
Como o código se organiza
As views ficam finas: recebem o pedido e chamam os services para escrever ou os selectors para ler. O worker usa os mesmos services. Os pedidos do HTMX recebem só o trecho de HTML que muda. JSON aparece em um lugar: no upload, a view devolve a URL assinada do S3 para o navegador mandar o áudio direto.
Uma gravação, do microfone à nota
O áudio não passa pela API. O navegador recebe uma URL assinada e manda o arquivo direto pro S3. O serviço não carrega o áudio na memória nem segura uma conexão aberta durante o envio. No banco fica só a referência do arquivo.
O trabalho pesado fica fora da requisição. Converter com ffmpeg e transcrever com o Gemini leva tempo, então isso roda numa tarefa do worker. A requisição só registra, enfileira e responde na hora.
Estado e fila deixam o processo fácil de refazer. Cada gravação tem um status: enviando, na fila, processando, concluído ou erro. Como o áudio original já está no S3, uma gravação com erro volta pra fila sem precisar ser enviada de novo. Um envio que ficou parado é conferido no S3: se o arquivo chegou, vai pra fila; se não, vira erro de envio. É uma etapa que pode falhar no meio, e assim sempre dá pra saber onde cada gravação parou.
Só um worker pega cada gravação
O mesmo id pode chegar na fila mais de uma vez, e dois workers podem pegar a mesma gravação ao mesmo tempo. Consultar o status e depois atualizar não resolve, porque entre as duas operações o outro worker faz a mesma consulta.
Por isso a troca é um UPDATE com o status esperado no WHERE: checagem e escrita viram uma operação atômica. Quem altera a linha processa, quem altera zero linhas desiste. É um compare-and-swap, sem lock distribuído.
O glossário que aprende
O Gemini errava sempre as mesmas palavras nos meus áudios: Mayra virava Maira, Victor virava Vitor e a daily do trabalho virava “dele”. É o meu jeito de falar, que às vezes engole letras, e isso nenhum prompt genérico resolve.
Então a correção que faço na nota vira vocabulário. O diff entre o texto gerado e o editado guarda cada troca, e um termo corrigido em pelo menos duas gravações entra no prompt das próximas, junto com as formas erradas que já apareceram. O prompt avisa que a lista serve só para grafia, para a LLM não inventar conteúdo por causa dela.
Implantação
Em outros projetos testei um fluxo com Lambda na AWS e não gostei. Aqui o objetivo era praticidade e simplicidade: uma VPS só, com Docker Compose, atrás da Cloudflare. Docker e Compose já fazem parte do meu dia a dia, então API, worker e Redis viram serviços do mesmo arquivo, sem nada novo para aprender só para subir o projeto. E cuidar do próprio servidor me ajuda a aprender administração de servidores.
Os áudios ficam no S3, e o SQLite vai para o S3 num backup diário, que um workflow confere todo dia. Um push na master roda os testes, gera a imagem e faz o deploy por SSH.