O LLM lê, o código confere: um loop de autocorreção
No trabalho, desenvolvo APIs que leem documentos com OCR e LLM. Uma delas analisa matrículas de imóvel e, entre outras coisas, extrai quem são os proprietários e qual fração cada um tem. É o tipo de extração em que o modelo erra de um jeito difícil de ver: lê a cadeia de compras, doações e partilhas e devolve frações que parecem razoáveis, mas que não fecham.
A saída que encontrei foi simples. Depois que o LLM responde, o código soma as frações. Se não der 100%, a resposta volta para o modelo junto com o que deu errado, e ele tenta de novo, até três rodadas. Isso ajudou bastante a aumentar a confiabilidade da extração.
Gostei da técnica e quis praticá-la de novo, num problema diferente e com dados públicos, para fixar o conhecimento e ter uma referência caso precise implementá-la outra vez. Todo o código está em rafaellcoellho/llm-validation-loop.
O exercício
Eu precisava de documentos reais com uma resposta certa conhecida. As atas da eleição presidencial venezuelana de 2024 servem: dezenas de milhares de fotos e scans foram publicados, e cada ata imprime um QR code com os próprios votos, que vira o gabarito. Usei a amostra e os QR codes decodificados do repositório Strvm/vnzla-libre.
Cada ata lista os votos de 38 partidos que apoiam 10 candidatos, e cada número aparece duas vezes: em dígitos e por extenso, em espanhol.
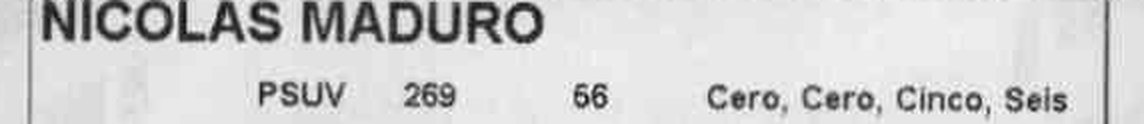
Essa redundância é o que o código confere:
| Regra | O que confere |
|---|---|
party_sum |
os 38 partidos somam os Votos válidos |
digits_match_words |
56 bate com Cero, Cero, Cinco, Seis |
summary_total |
Votos = válidos + nulos + vazios |
machine_voters |
votantes na máquina = Votos |
registered_voters |
Votos ≤ eleitores |
party_order |
as 38 linhas, na ordem da cédula |
O QR code é cortado da imagem antes de o modelo ver a ata. Ele só serve para medir o resultado no fim, nunca entra no loop.
O loop
O loop em si não sabe nada de atas. Recebe uma função que extrai e uma que valida:
def run_validation_loop(extract, validate, max_rounds=3):
    attempts = []

    for round_number in range(1, max_rounds + 1):
        attempt = _run_round(extract, validate, attempts, round_number)
        attempts.append(attempt)
        if attempt.passed:
            break

    return LoopResult(attempts)


def _run_round(extract, validate, history, round_number):
    extraction = extract(list(history))
    violations = validate(extraction.output)

    return Attempt(round_number, extraction.output, violations, extraction.usage)
A cada rodada, o extrator recebe o histórico e monta a mesma conversa: a fonte, o prompt e, para cada tentativa anterior, a resposta do modelo seguida das regras que ela quebrou. As regras são funções puras que devolvem mensagens específicas, com o esperado e o encontrado.
Testei duas entradas diferentes, com o mesmo loop e o mesmo modelo
(gemini-3.5-flash-lite):
- Visão: o modelo recebe três recortes da imagem da ata.
- OCR → texto: um OCR local (RapidOCR) transforma a imagem em texto, e o modelo só vê o texto.
Uma correção, do começo ao fim
Na ata 050201001.01, lendo pela imagem, o modelo leu a linha do PSUV como
66 na primeira rodada:
{
  "party": "PSUV",
  "votes": { "digits": 66, "words": "Cero, Cero, Cinco, Seis" }
}
O código respondeu na mesma conversa:
Your answer in round 1 failed these checks:
- [digits_match_words] PSUV: digits say 66, but the words 'Cero, Cero, Cinco, Seis' say 56.
- [party_sum] The party votes add up to 491, but 'Votos validos' is 481 (difference +10).

Look at the source again, only at the fields involved, and fix what was misread.
Do not change a value just to make a check pass: if a value really reads that
way, keep it. Return the complete JSON again.
Na segunda rodada veio 56, todas as regras passaram e o resultado bateu com o
QR code. Esse erro, o 5 impresso lido como 6, foi o mais comum da rodada
inteira, e a coluna por extenso resolveu quase todos.
Os números
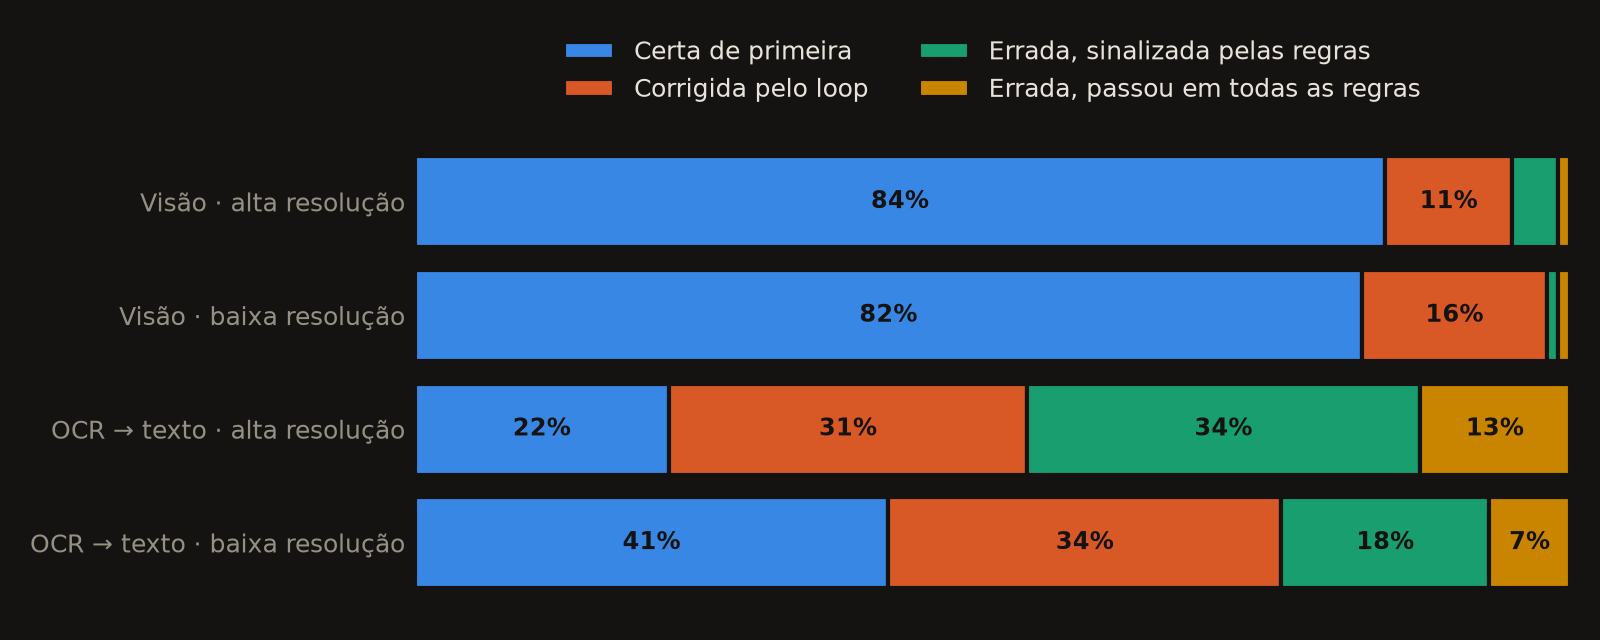
Rodei 200 atas (100 escaneadas em alta resolução e 100 em baixa), cada uma pelas duas entradas, com até três rodadas por ata.
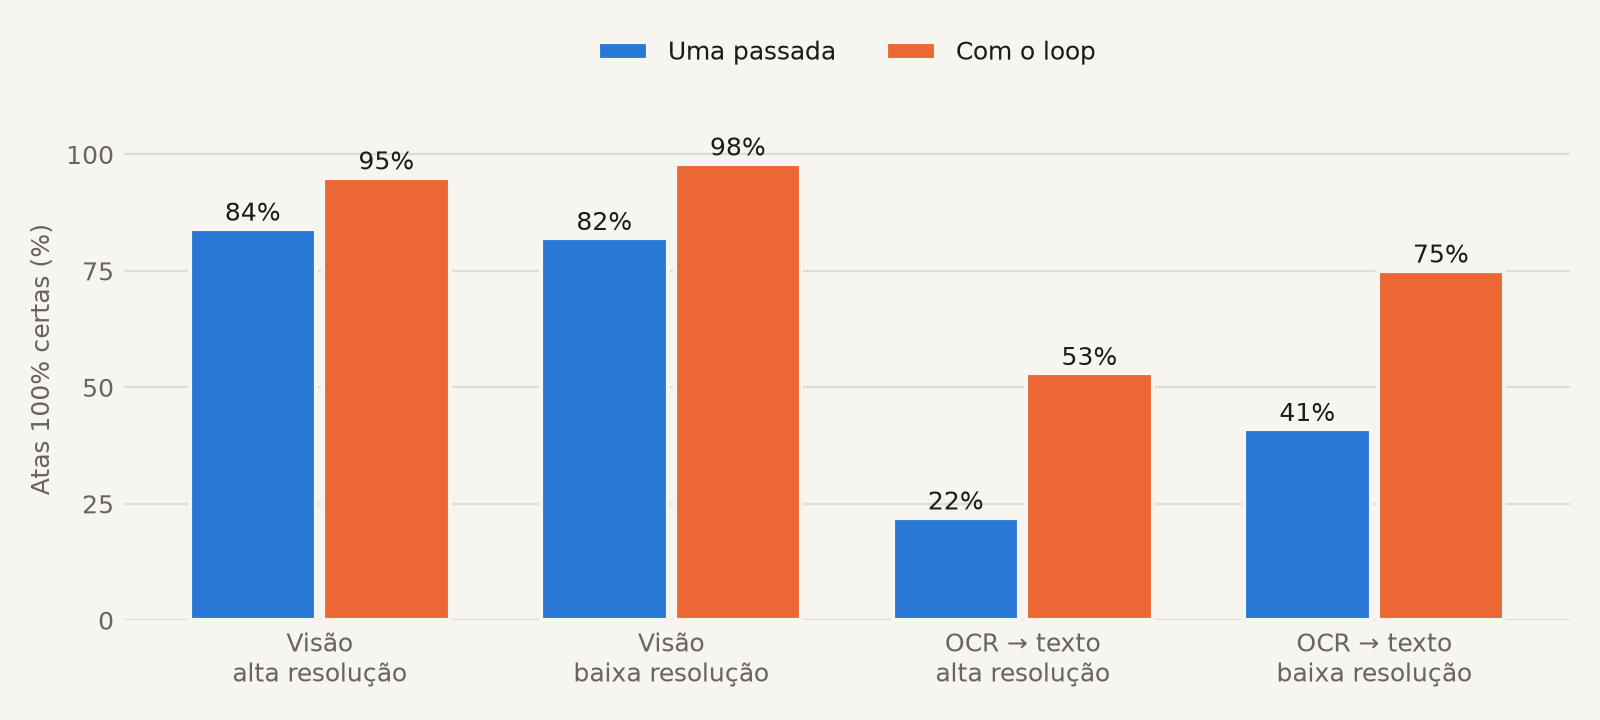
| Entrada | Uma passada | Com o loop | Errada, sinalizada | Errada, passou em tudo | Custo |
|---|---|---|---|---|---|
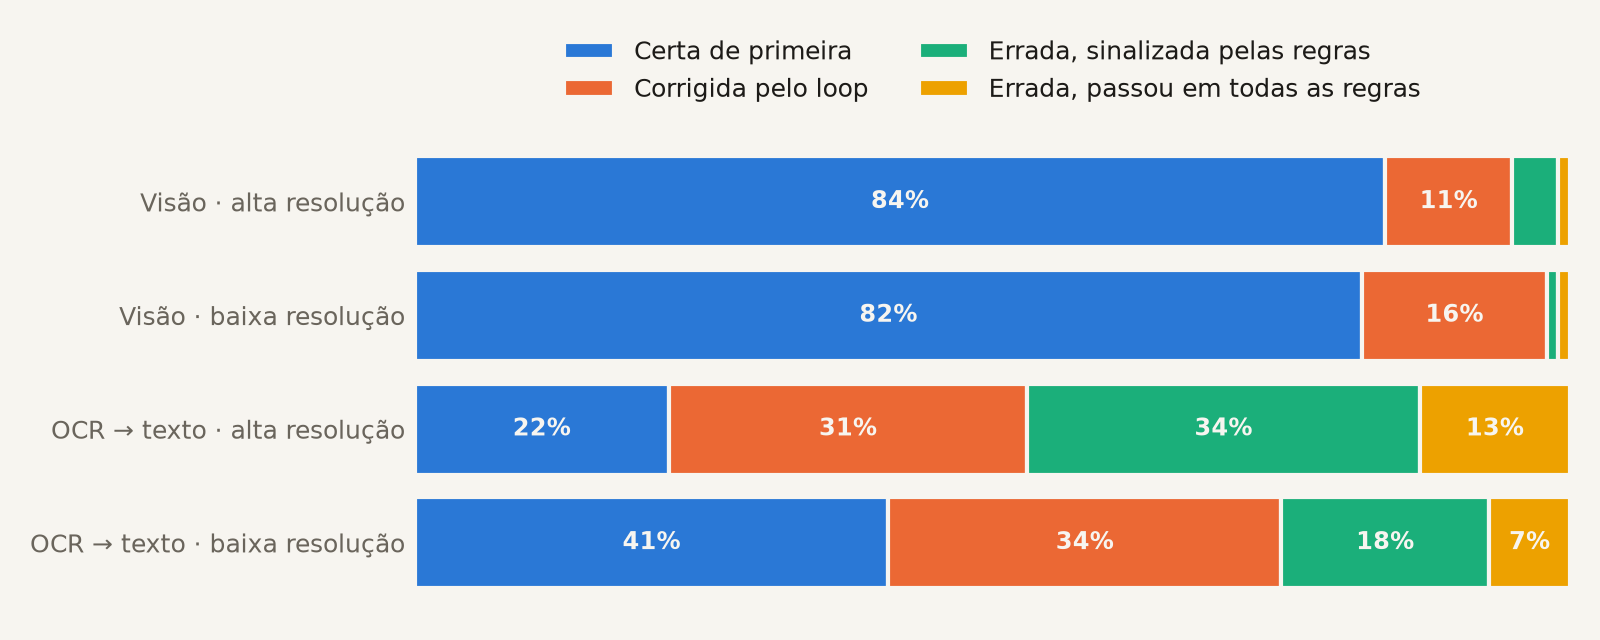
| Visão | 83,0% | 96,5% | 5 | 2 | US$ 1,55 |
| OCR → texto | 31,5% | 64,0% | 52 | 20 | US$ 2,51 |
O que chamou a atenção:
- O loop nunca estragou uma resposta certa. Nenhuma ata que estava certa na primeira rodada terminou errada.
- Pela imagem, o loop fecha quase tudo. O modelo consegue reler a linha que falhou, e a redundância da própria ata desempata.
- Pelo OCR, o ganho é grande, mas o ponto de partida é ruim. O texto já
chega corrompido (
Carono lugar deCero, dígitos que somem), e o modelo tenta corrigir erros que não consegue ver. É também onde cresce o pior desfecho: 10% das atas passaram em todas as regras e continuaram erradas. - Sinalizada não é perdida. Uma ata que não fecha vai para uma pessoa conferir já com a regra que quebrou, o que é muito mais barato do que revisar tudo.
O que a conta não pega
Passar em todas as regras quer dizer que os números são consistentes, não que estão certos. Três casos da rodada:
O modelo pode forçar a soma. Na ata 181103005.01, pelo OCR, a linha do PCV
perdeu o dígito (PCV 9 Cero, Cero, Core, Une). O modelo escreveu 0, e a
soma ficou um voto abaixo. Na segunda rodada, ele acrescentou esse voto ao
CONDE, uma linha que o OCR tinha lido como 0 sem nenhuma dúvida. Todas as
regras passaram, com dois valores errados. Das 20 atas de OCR que passaram
erradas, 17 chegaram lá desse jeito, mesmo com o feedback dizendo para não mudar
um valor só para passar na regra. Em outra, o modelo leu o total como 608
enquanto o extenso dizia 508, e depois somou 100 votos ao PSUV para fechar.
Alguns erros não mexem nas somas. Na ata 091002013.02, pela imagem, um
voto foi parar no BR em vez do DDP. Os dois partidos apoiam o mesmo candidato,
então nenhum total muda e nenhuma regra percebe.
Uma resposta degenerada passa em tudo. Na ata 010107017.03, depois de uma
primeira rodada quebrada, o modelo devolveu uma ata inteira de zeros. 0 = 0
passa em qualquer soma.
As regras só são tão fortes quanto a independência entre elas e os valores que conferem.
Quando usar
A técnica valeu a pena aqui porque quatro coisas eram verdade:
- Existe uma checagem determinística barata. Somas e valores duplicados, não opiniões.
- O modelo ainda enxerga a evidência. Um erro que ele consegue reler tem conserto; um erro que já veio embutido na entrada, não. É a diferença entre visão e OCR nos gráficos acima.
- O feedback é específico. “PSUV: os dígitos dizem 66, o extenso diz 56” funciona muito melhor do que “está errado, tente de novo”.
- As rodadas extras só custam nas falhas. Pela imagem, 80% das atas passaram de primeira, e as 200 custaram US$ 1,55.
Na matrícula de imóvel, a checagem é a soma das frações, e o modelo lê o texto inteiro do documento, então consegue reinterpretar a cadeia de atos quando a conta não fecha. Foi por isso que funcionou tão bem lá.
Referências
- Imagens das atas e QR codes decodificados: Strvm/vnzla-libre.
- Código, traces e resultados: rafaellcoellho/llm-validation-loop.